Семантический поиск: embeddings и чанки на Python
Как устроен поиск по смыслу: embeddings, зачем резать текст на чанки, схема хранения и рабочий пример на Python от документов до cosine search. Почему один вектор на книгу ломает точность?
2 просмотра
1 месяц назад
Поиск по ключевым словам ломается на синонимах и перефразировках. Запрос «как вернуть деньги» не находит абзац со словами «оформить возврат платежа», хотя смысл один.
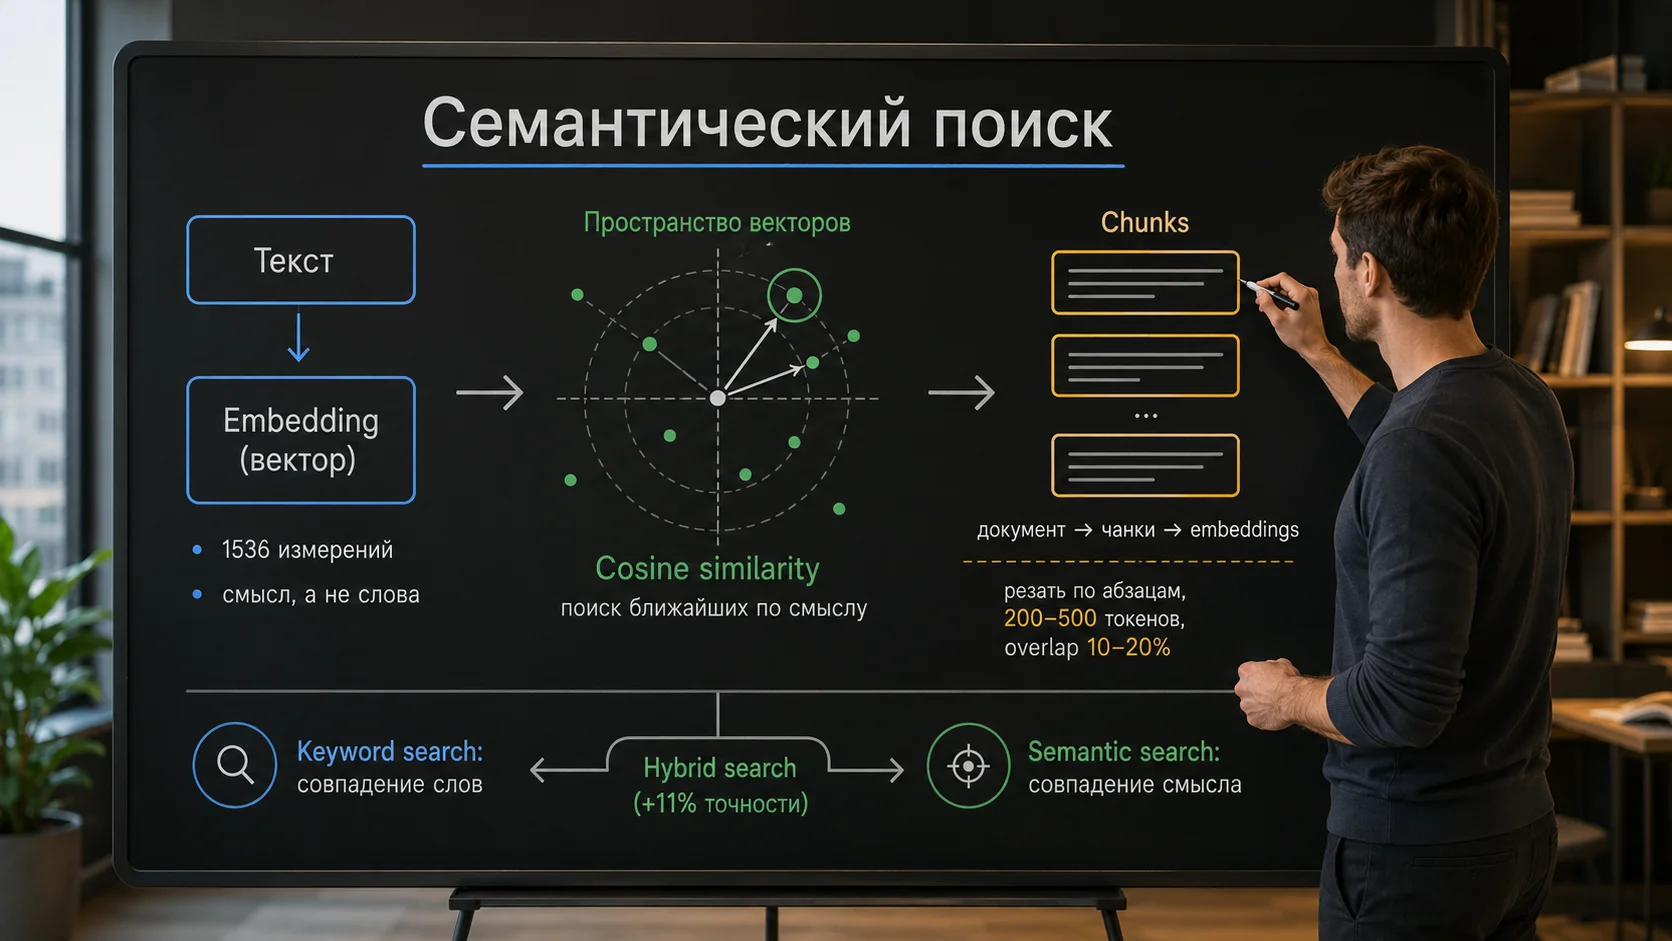
Семантический поиск решает задачу иначе. Текст превращают в числовой вектор — embedding. Похожие по смыслу фрагменты дают близкие векторы. Запрос тоже превращают в вектор и ищут ближайшие куски в базе.
Статья разбирает устройство такого поиска, роль чанков и сохранение данных. В конце — рабочие примеры на Python без привязки к конкретному продукту.
Короткие выводы: семантический поиск сравнивает смысл текстов через векторы, а не совпадение слов.
Embedding — массив чисел фиксированной длины. Модель
text-embedding-3-small от OpenAI возвращает вектор размерности 1536. Близкие смыслы дают близкие направления в пространстве. Метрику близости считают через cosine similarity.Обычный полнотекстовый индекс (BM25, Elasticsearch, PostgreSQL
tsvector) ищет совпадение токенов. Он силён на точных терминах, кодах и именах. Семантический поиск сильнее на перефразировках. На практике часто комбинируют оба подхода — hybrid search. В исследовании OpenHelm hybrid дал прирост точности около 11 процентных пунктов относительно чистого vector search.Короткие выводы: embedding кодирует смысл; keyword-индекс кодирует слова. Вместе они покрывают больше запросов.
Пайплайн строится из пяти шагов.
- 1.Из документа извлекают полный текст.
- 2.Текст режут на чанки — небольшие фрагменты.
- 3.Для каждого чанка считают embedding.
- 4.В базу пишут:
document_id,chunk_order,content,embedding. - 5.При запросе считают embedding запроса, находят ближайшие чанки и отдают их в LLM или в UI.
Полный текст документа хранят отдельно. Векторы живут на уровне чанков. Один вектор на весь документ для поиска почти не используют: длинный текст «размазывает» тему.
Схема потока:
Text
документ → full_text → chunks → embeddings → таблица чанков ↓ запрос → embedding запроса → поиск ближайших → релевантные фрагменты
Короткие выводы: ищут не «документ в среднем», а конкретный фрагмент с ответом.
Интуиция «сумма частей равна целому» здесь не работает. Чанки не схлопывают в один вектор при индексации документа. Каждый кусок хранит свой
content и свой embedding.Смысл разреза — разрешение поиска. Нужен локальный сигнал: найти абзац в середине книги, а не среднее по всей книге.
Пример. Книга на 50 страниц. Вопрос касается одного абзаца в главе 7. Один вектор на всю книгу смешивает сотни тем. Cosine similarity с запросом слабый. Вектор именно того абзаца даёт точное попадание. В контекст модели можно отдать этот фрагмент, а не весь файл.
Mean pooling — отдельный приём. Несколько векторов усредняют, когда нужен один вектор на длинный note или query, а модель не принимает весь текст. Это обход лимита входа, а не «лучшая математика суммы». Для поиска по документам mean pooling по книге ухудшает точность: среднее глушит локальный сигнал.
Короткие выводы: чанки дают разрешение поиска. Среднее по всей книге ≠ поиск по нужному куску.
Абзац часто совпадает с одной мыслью. Embedding получается «чище», поиск точнее находит нужный кусок. На практике абзац — хорошая предпочтительная граница, но не жёсткое правило «один абзац = один chunk».
Рабочий компромисс — гибрид:
- •резать по структуре: заголовки → абзацы → предложения;
- •держать размер roughly 200–500 токенов;
- •давать overlap 10–20%, чтобы не рвать связку между соседями;
- •для Markdown/HTML сначала резать по заголовкам, потом дробить крупные секции.
Chroma Research показывает:
RecursiveCharacterTextSplitter около 400 токенов даёт recall порядка 85–90%. Overlap 10–20% стабильно улучшает результат. Жёсткое «только абзацы» проигрывает гибриду на реальных документах.Короткие выводы: абзац — предпочтительная граница. Потолок по токенам и overlap обязательны.
Отдельное поле
embedding на всём документе для поиска не подходит. Нужна таблица чанков.Минимальная схема (PostgreSQL +
pgvector или любая vector DB):SQL
CREATE TABLE documents ( id TEXT PRIMARY KEY, title TEXT NOT NULL, full_text TEXT NOT NULL, created_at TIMESTAMPTZ DEFAULT now() ); CREATE TABLE document_chunks ( id BIGSERIAL PRIMARY KEY, document_id TEXT NOT NULL REFERENCES documents(id) ON DELETE CASCADE, chunk_order INT NOT NULL, content TEXT NOT NULL, embedding VECTOR(1536) NOT NULL, -- размерность зависит от модели UNIQUE (document_id, chunk_order) ); CREATE INDEX ON document_chunks USING ivfflat (embedding vector_cosine_ops);
Пример строк после индексации:
При переиндексации документа старые чанки удаляют, затем пишут новые. Иначе поиск возвращает устаревшие фрагменты.
Короткие выводы: документ хранит полный текст; поиск работает по таблице чанков с векторами.
Ниже — минимальный рабочий контур. Для эмбеддингов используют OpenAI API. Тот же паттерн работает с локальными моделями через совместимый endpoint.
Установка:
Bash
pip install openai numpy langchain-text-splitters
Python
DOCUMENTS = [ { "id": "doc_refund", "title": "Возврат средств", "full_text": ( "Возврат оформляют в личном кабинете в разделе «Платежи».\n\n" "Срок возврата — 14 дней с даты оплаты. Деньги приходят на ту же карту.\n\n" "Частичный возврат доступен, если товар ещё не отгрузили." ), }, { "id": "doc_ship", "title": "Доставка", "full_text": ( "Доставка занимает 3–5 рабочих дней по России.\n\n" "Международная доставка занимает до 21 дня.\n\n" "Трек-номер появляется в кабинете после передачи заказа курьеру." ), }, ]
Python
from langchain_text_splitters import RecursiveCharacterTextSplitter splitter = RecursiveCharacterTextSplitter( chunk_size=400, # ориентир в символах; в проде лучше считать токены chunk_overlap=60, # ~15% separators=["\n\n", "\n", ". ", " ", ""], ) def make_chunks(doc: dict) -> list[dict]: parts = splitter.split_text(doc["full_text"]) return [ { "document_id": doc["id"], "chunk_order": i, "content": part, } for i, part in enumerate(parts) ]
Сплиттер сначала режет по абзацам (
\n\n), затем по строкам и предложениям. Абзац остаётся целым, пока укладывается в лимит. Это и есть гибрид «абзац + потолок размера».Python
import os from openai import OpenAI client = OpenAI(api_key=os.environ["OPENAI_API_KEY"]) MODEL = "text-embedding-3-small" def embed_texts(texts: list[str]) -> list[list[float]]: response = client.embeddings.create(model=MODEL, input=texts) # API возвращает объекты с index — сортируем на всякий случай sorted_data = sorted(response.data, key=lambda x: x.index) return [item.embedding for item in sorted_data]
В проде сюда ставят PostgreSQL/
pgvector, Qdrant, Chroma или SurrealDB. Для демонстрации хватает списка словарей.Python
import numpy as np store: list[dict] = [] for doc in DOCUMENTS: chunks = make_chunks(doc) vectors = embed_texts([c["content"] for c in chunks]) for chunk, vector in zip(chunks, vectors): store.append({**chunk, "embedding": np.array(vector, dtype=np.float64)})
Python
def cosine_similarity(a: np.ndarray, b: np.ndarray) -> float: return float(np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))) def search(query: str, top_k: int = 3) -> list[dict]: query_vec = np.array(embed_texts([query])[0], dtype=np.float64) scored = [] for row in store: score = cosine_similarity(query_vec, row["embedding"]) scored.append({**row, "score": score}) scored.sort(key=lambda x: x["score"], reverse=True) return scored[:top_k] results = search("как вернуть деньги за заказ") for r in results: print(f"{r['score']:.3f} | {r['document_id']}#{r['chunk_order']}") print(r["content"]) print("---")
Ожидаемый результат: сверху окажется чанк из
doc_refund про возврат, даже без слов «вернуть деньги» в тексте. Запрос про трек-номер вытянет чанк из doc_ship.Python
def build_context(query: str, top_k: int = 3) -> str: hits = search(query, top_k=top_k) blocks = [ f"[{h['document_id']}#{h['chunk_order']}]\n{h['content']}" for h in hits ] return "\n\n".join(blocks) # context = build_context("срок возврата средств") # дальше: system + context + вопрос пользователя → chat completions
Модель отвечает по найденным кускам. Галлюцинации падают, потому что в промпте лежит конкретный фрагмент источника.
Короткие выводы: минимальный контур — chunk → embed → store → cosine search → контекст для ответа.
Ниже — демонстрация, почему «среднее по книге» ломает поиск. Код учебный: показывает разницу сигналов.
Python
def mean_pool(vectors: list[np.ndarray]) -> np.ndarray: stacked = np.stack([v / np.linalg.norm(v) for v in vectors]) mean = stacked.mean(axis=0) return mean / np.linalg.norm(mean) # чанки одной «книги» про разные темы book_chunks = [ "Глава про доставку: сроки 3–5 дней по России.", "Глава про возврат: оформить заявку в кабинете за 14 дней.", "Глава про бонусы: кешбэк 5% за повторную покупку.", ] book_vectors = [np.array(v) for v in embed_texts(book_chunks)] book_mean = mean_pool(book_vectors) query = "как оформить возврат" q = np.array(embed_texts([query])[0]) print("score к среднему по книге:", cosine_similarity(q, book_mean)) print("score к чанку про возврат:", cosine_similarity(q, book_vectors[1])) print("score к чанку про доставку:", cosine_similarity(q, book_vectors[0]))
Score к чанку про возврат будет выше, чем к среднему по книге. Среднее смешивает доставку, возврат и бонусы. Локальный вектор сохраняет тему.
Короткие выводы: для индексации источников хранят отдельный вектор на каждый чанк. Mean pooling оставляют для коротких сущностей с лимитом входа.
- •Одна и та же embedding-модель для документов и запросов.
- •Размерность вектора в схеме совпадает с моделью.
- •При обновлении документа чанки пересобирают целиком.
- •Размер чанка держат в диапазоне 200–500 токенов, overlap — 10–20%.
- •Для оценки качества готовят набор «вопрос → ожидаемый фрагмент» и меряют recall@k.
- •Keyword-поиск оставляют рядом: артикулы, ID, точные имена лучше ловит BM25.
Полезные материалы:
- •
- •
- •
- •
- •
Короткие выводы: продакшен упирается в переиндексацию, единую модель и измерение recall, а не в «магическое» поле embedding на документе.
Семантический поиск переводит текст и запрос в векторы и сравнивает смысл. Документ хранят целиком, а ищут по чанкам: у каждого куска свой embedding.
Чанки нужны не чтобы «сохранить ту же сумму», а чтобы найти и вернуть нужный фрагмент. Абзац — удобная граница, но без потолка по размеру и overlap точность падает.
Минимальная практика: разрезать текст → посчитать embeddings → сохранить в таблицу чанков → искать cosine similarity → отдавать top-k в ответ или в LLM.
Авторы файла
Информацию подготовили
Автор текста
Fullstack веб-разработчик
Моя специализация включает разработку веб-сайтов, приложений и интерфейсов, работу с базами данных, а также разворачиванием полноценного веб сервера.
Комментарии файла
124 активных участника
Похожие файлы
Здесь структурирована база знаний приложения